robots.txt: 5 Fehler, die wir auf unserer Website fanden
Wir prüfen robots.txt, Sitemaps und Indexierung regelmäßig, bei Kundenprojekten genauso wie auf unserer eigenen Website. Bei der letzten Prüfung war unsere robots.txt in Teilen veraltet: 88 Zeilen, über Jahre ergänzt, und manche Einträge passten nicht mehr zu dem, was wir heute wollen. Am 14. November 2026 haben wir sie deshalb neu geschrieben. Beim Durchgehen fanden wir 5 Fehler, einer davon sperrte den Crawler einer echten Suchmaschine aus. Die alte Fassung vom 9. Mai 2026 liegt im Internet Archive, alle Zitate unten stammen daraus.
Wir zeigen die Fehler, weil sie typisch sind. Eine robots.txt fällt nicht auf, solange die Website läuft. Sie wird ergänzt, kopiert und selten wieder gelesen. Jeder Fehler hier hätte auf deiner Website genauso passieren können.
Was die robots.txt kann und was nicht
Die robots.txt sagt Crawlern, welche Pfade sie abrufen dürfen. Sie steuert das Crawlen, nicht die Indexierung. Diese Unterscheidung steckt hinter dem ersten Fehler. Seit 2022 ist das Format als RFC 9309 standardisiert, Google beschreibt seine Auslegung in der Search-Central-Dokumentation. Beide Quellen haben wir für jeden Befund herangezogen.
Fehler 1: Disallow versteckt das noindex
Die alte Datei sperrte für alle Crawler 6 Seiten:
| Zeile | Eintrag |
|---|---|
| 3 | User-agent: * |
| 4 bis 9 | Disallow: /agb, /impressum, /datenschutz, /termin-buchen, /danke-termin, /rich-text-components |
Die Absicht war klar: Rechtstexte und Terminseiten sollen nicht bei Google erscheinen. Die Sperre kann aber das Gegenteil bewirken. Google schreibt dazu: Wenn Seiten nicht gecrawlt werden dürfen, kann Google den Inhalt nicht indexieren, die URL aber trotzdem ohne Snippet anzeigen. Ein noindex im Seitenkopf sieht der Crawler nur, wenn er die Seite abrufen darf. Die Sperre verhindert also genau das Signal, das die Seite aus dem Index halten würde. In unserer Search Console tauchten Impressum, Datenschutz und AGB in 16 Monaten zwar nie auf, ein Schaden lässt sich also nicht nachweisen. Richtig war die Sperre trotzdem nicht.
Jetzt: Alle Seiten sind zum Crawlen freigegeben. Die 5 Seiten, die es noch gibt, tragen ein noindex im Seitenkopf. Bei Dateien ohne HTML-Kopf, etwa PDFs, übernimmt das der X-Robots-Tag im HTTP-Header.
Fehler 2: Eine Leerzeile mitten in der Gruppe
Dieser Fehler ist der unauffälligste. Die Zeilen 11 bis 15 sollten das Internet Archive und den Crawler MJ12bot aussperren:
| Zeile | Eintrag |
|---|---|
| 11 | User-agent: ia_archiver |
| 12 | User-agent: archive.org_bot |
| 13 | (leer) |
| 14 | User-agent: MJ12bot |
| 15 | Disallow: / |
Nach RFC 9309 tut die Datei genau das. Eine Gruppe besteht dort aus einer oder mehreren User-agent-Zeilen und den Regeln danach, und sie endet erst mit der nächsten User-agent-Zeile nach einer Regel oder mit dem Dateiende. Eine Leerzeile spielt keine Rolle. Die Zeilen 11, 12 und 14 bilden also eine Gruppe, und „Disallow: /“ gilt für alle 3 Crawler.
Der ursprüngliche Standard von 1994 sieht das anders: Dort trennen Leerzeilen die Einträge, und jeder Eintrag braucht mindestens eine Disallow-Zeile. Für einen Crawler, der sich daran hält, sind die Zeilen 11 und 12 ein eigener Eintrag ohne Regel und damit ungültig. Ob die Sperre greift, hing also davon ab, nach welchem Standard ein Crawler die Datei liest. Gespeichert hat das Internet Archive unsere Startseite trotzdem weiter, zuletzt im Oktober 2026. Eine Regel, die 2 Lesarten zulässt, ist ein Fehler, auch wenn Google sie richtig versteht.
Jetzt: Innerhalb einer Gruppe steht keine Leerzeile mehr. Jede Gruppe hat einen Kommentar, der ihren Zweck nennt, und endet mit einer Regel.
Fehler 3: Eine echte Suchmaschine war gesperrt
Zwischen Analysewerkzeugen und ausländischen Suchmaschinen stand diese Gruppe:
| Zeile | Eintrag |
|---|---|
| 45 | User-agent: DuckDuckBot |
| 46 | Disallow: / |
DuckDuckBot ist der Crawler von DuckDuckGo, einer Suchmaschine, die viele datenschutzbewusste Nutzer verwenden. Für eine Agentur, die von Anfragen lebt, gibt es keinen Grund, sie auszusperren. Wie stark sich das ausgewirkt hat, können wir nicht messen. Die Zeile stammt vermutlich aus einer übernommenen Sperrliste, wie sie im Netz zu Dutzenden kursieren. Genau das ist das Risiko kopierter Listen: Kaum jemand prüft jeden Eintrag.
Jetzt: DuckDuckBot steht nicht mehr in der Datei und darf über die Gruppe für alle Crawler alles abrufen.
Fehler 4: Bot-Namen, die es so nicht gibt
Ein Crawler sucht in der robots.txt nach seinem eigenen Namen, dem sogenannten Product Token. Laut RFC 9309 darf dieser Name nur aus Buchstaben, Unterstrichen und Bindestrichen bestehen. 2 Einträge der alten Datei konnten deshalb nie greifen:
- „SEMrush Sensor Bot“ enthält Leerzeichen und ist kein gültiger Name. Semrush nennt auf seiner Bot-Seite stattdessen Namen wie SemrushBot und SiteAuditBot.
- „SEO-Kicks“ trifft den Crawler nicht, denn er meldet sich laut Betreiber als „SEOkicks“.
Ein dritter Eintrag sah verdächtig aus, war aber harmlos: „DotBot“ mit 7 Leerzeichen am Zeilenende. Google ignoriert Leerzeichen am Anfang und Ende einer Zeile. Ebenfalls harmlos, aber ein Zeichen für eine gewachsene Datei: Baiduspider und DotBot standen jeweils 2-mal drin.
Jetzt: Jeder Name ist mit der Dokumentation des Betreibers abgeglichen.
Fehler 5: Die Sitemap-Zeile stand doppelt
Dieser Fehler kam erst Anfang November dazu, und er ist eine Eigenheit von Webflow. Wir haben neben der Sitemap von Webflow eine zweite Sitemap für unsere eigenen Werkzeuge, etwa den UTM-Generator. Beide trugen wir oben in die robots.txt ein. Webflow hängt aber automatisch eine eigene Zeile für die sitemap.xml an. Die stand danach 2-mal in der Datei.
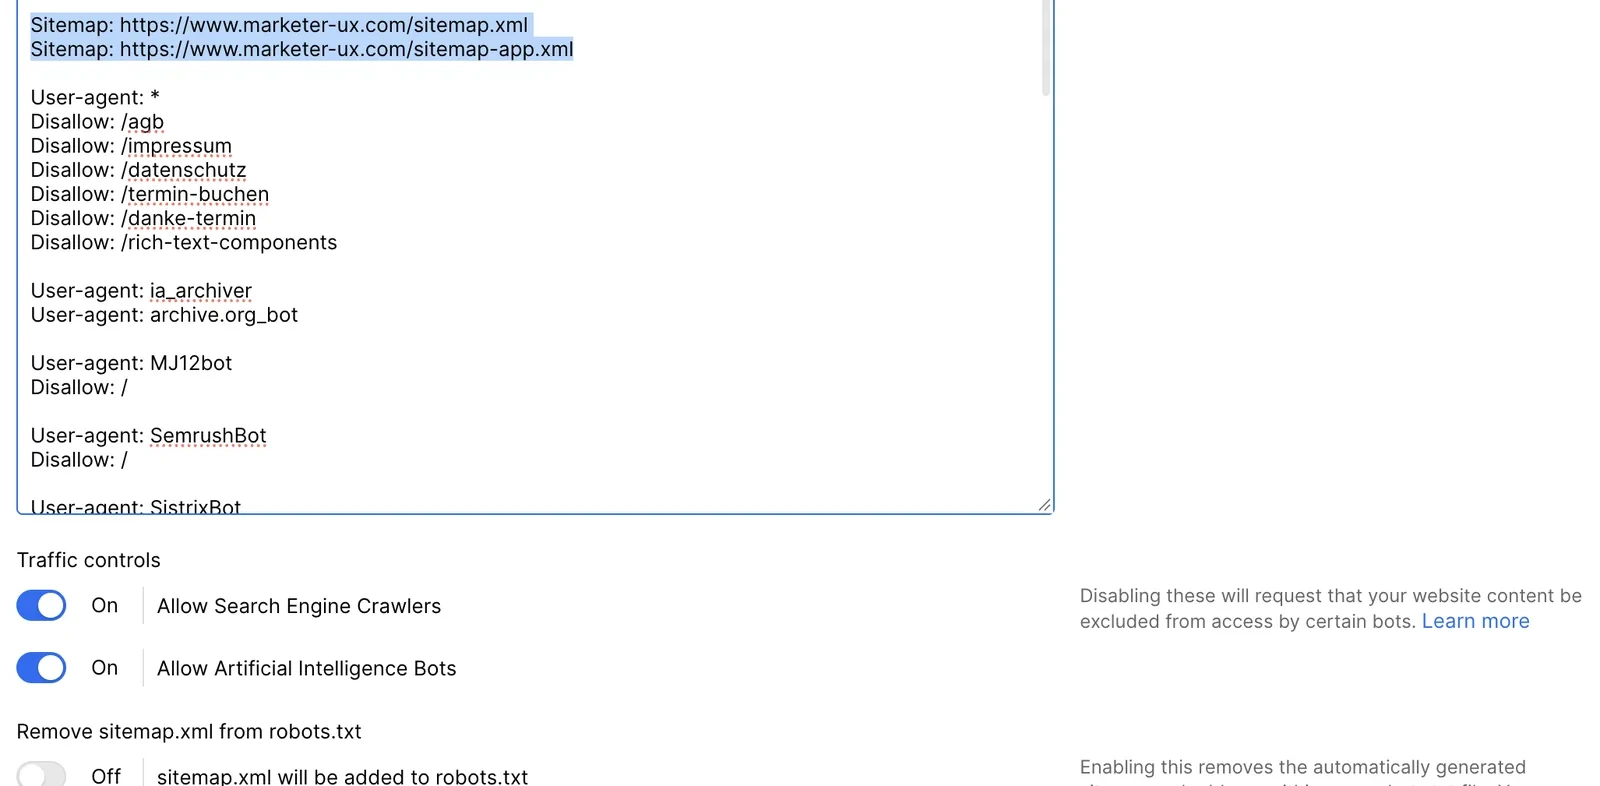
Das schadet nicht, Crawler werten doppelte Zeilen nur einmal aus. Sauber ist es trotzdem nicht. Webflow bietet dafür den Schalter „Remove sitemap.xml from robots.txt“. Ist er an, stehen nur die Sitemap-Zeilen in der Datei, die man selbst einträgt. Ist er aus, trägt man selbst nur die zusätzlichen Sitemaps ein. Wir haben ihn eingeschaltet, damit beide Sitemaps zusammen oben in der Datei stehen.
Jetzt: Jede Sitemap steht genau einmal in der Datei.
Die Falle beim Umbau: Eine eigene Gruppe hebelt * aus
Beim Neuschreiben haben wir KI-Crawlern wie GPTBot, ClaudeBot und PerplexityBot eigene Gruppen gegeben. Dabei gilt eine Regel, die viele übersehen: Für jeden Crawler gilt nur eine Gruppe, nämlich die mit dem passendsten Namen. Alle anderen Gruppen ignoriert er, auch die für alle Crawler mit „*“.
Hätten wir die Rechtstexte weiter per Disallow unter „*“ gesperrt, wären sie für jeden Crawler mit eigener Gruppe offen gewesen. Wer einem Bot eine eigene Gruppe gibt, muss deshalb alle Regeln aus „*“ dort wiederholen. Wir haben das Problem an der Wurzel gelöst: Unter „*“ steht nur noch „Allow: /“, und was nicht in den Index soll, regelt das noindex auf der Seite. Das gilt für jeden Crawler, egal in welcher Gruppe er steht.
So ist unsere robots.txt heute aufgebaut
Die neue Datei hat 55 Zeilen in 6 Gruppen, jede mit einem Kommentar:
| Gruppe | Regel | Warum |
|---|---|---|
| Alle Crawler (*) | Allow: / | Indexierung steuern wir per noindex auf der Seite. |
| KI-Suche und Antwortmaschinen, etwa OAI-SearchBot, Claude-SearchBot, PerplexityBot | Allow: / | Wir wollen in KI-Antworten genannt werden. |
| Training und Grounding, etwa GPTBot, ClaudeBot, Google-Extended | Allow: / | Für die Sichtbarkeit in KI-Antworten (GEO, LLMO, AEO) sollen unsere Inhalte in Sprachmodelle einfließen. |
| Analyse- und Wettbewerbswerkzeuge, etwa AhrefsBot, SemrushBot | Disallow: / | Sie erzeugen Last und liefern Wettbewerbern Daten über uns. |
| Weitere Suchmaschinen, etwa Baiduspider, SeznamBot, Exabot | Disallow: / | Sie verbrauchen Bandbreite und bringen aus unseren Märkten keine Besucher. |
| Verfügbarkeitsprüfer, etwa UptimeRobot, Pingdom | Allow: / | Überwachungsdienste sollen die Erreichbarkeit prüfen dürfen. |
Die Entscheidung für KI-Crawler ist bewusst gefallen. Wer in ChatGPT, Gemini und Perplexity auftauchen will, muss deren Crawler hereinlassen. Wie das mit der llms.txt zusammenspielt und was sonst für Sichtbarkeit in KI-Antworten zählt, zeigen wir auf unserer Seite zur GEO- und LLMO-Optimierung.
Checkliste für deine robots.txt
- Disallow nicht für Seiten nutzen, die nur aus dem Index sollen. Dafür ist noindex da.
- Keine Leerzeile innerhalb einer Gruppe. Nicht jeder Crawler liest sie gleich.
- Jeden gesperrten Crawler kennen. Steht eine Suchmaschine drin, die Besucher bringt?
- Namen beim Betreiber nachschlagen. Keine Leerzeichen, genaue Schreibweise.
- Eigene Gruppen vollständig machen. Was unter „*“ steht, gilt dort nicht.
- Jede Sitemap genau einmal eintragen. Bei Webflow auf die automatische Zeile achten.
Prüfen lässt sich das in der Google Search Console. Der robots.txt-Bericht zeigt, welche Fassung Google zuletzt abgerufen hat. Der Status „Indexiert, obwohl durch robots.txt-Datei blockiert“ im Bericht zur Seitenindexierung verrät genau den ersten Fehler.
Unsere alte robots.txt sah harmlos aus und hat trotzdem den Crawler einer Suchmaschine ausgesperrt. Genau deshalb gehört sie zu jeder Prüfung. Wenn du wissen willst, wie es um deine Website steht, schauen wir sie uns gemeinsam an. Als Webflow-Agentur prüfen wir robots.txt, Sitemaps und Indexierung bei jedem Projekt mit, sprich uns an.
FAQ
Reicht Disallow in der robots.txt, um eine Seite aus Google herauszuhalten?
Nein. Disallow verhindert nur das Crawlen. Google kann die URL trotzdem ohne Snippet anzeigen. Damit eine Seite nicht in den Index kommt, braucht sie ein noindex im Seitenkopf oder im X-Robots-Tag, und sie darf dafür nicht per robots.txt gesperrt sein.
Beendet eine Leerzeile eine Gruppe in der robots.txt?
Nach RFC 9309 nicht. Dort endet eine Gruppe erst mit der nächsten User-agent-Zeile nach einer Regel oder mit dem Dateiende. Der ursprüngliche Standard von 1994 trennt Einträge dagegen durch Leerzeilen. Damit jeder Crawler die Datei gleich liest, gehört innerhalb einer Gruppe keine Leerzeile.
Sollte man KI-Crawler in der robots.txt sperren?
Das hängt vom Ziel ab. Wer in ChatGPT, Gemini oder Perplexity genannt werden will, muss deren Crawler zulassen. Wir lassen KI-Suche und Training bewusst zu. Wichtig: Ein Crawler mit eigener Gruppe ignoriert die Regeln unter „*“, sie müssen dort wiederholt werden.